KI-Chatbots im Wissenstest: Kolorektalkarzinom
Da sich KI-Modelle kontinuierlich weiterentwickeln, ist vor ihrem Einsatz in spezialisierten medizinischen Fachgebieten wie der Behandlung des Kolorektalkarzinoms eine sorgfältige Validierung erforderlich. Ziel dieser Pilotstudie war es, Wissen, Sicherheit und Grenzen der Schlussfolgerungsfähigkeit von sechs fortschrittlichen KI-Chatbots anhand eines standardisierten Multiple-Choice-Formats vergleichend zu untersuchen. Insgesamt wurden 137 textbasierte Fragen aus zwölf Kernbereichen des Kolorektalkarzinoms aus den chinesischen Leitlinien von 2023 adaptiert. Getestet wurden Gemini 3 Pro Preview, GPT-5.1, Kimi K2 Thinking, DeepSeek V3.2, Qwen3-Max und Claude Opus 4.5. Die Modelle erhielten die Fragen unter Zero-Shot-Bedingungen und wurden angewiesen, keine einzelnen Schlussfolgerungsschritte darzustellen. Neben quantitativen statistischen Auswertungen erfolgte eine qualitative Analyse der Fehlerarten.
Die Gesamtgenauigkeit war niedrig: Kimi K2 Thinking erreichte 27,74 % (SD = 0,45), Claude Opus 4.5 26,28 % (SD = 0,44), Gemini 3 Pro 16,06 % (SD = 0,37), DeepSeek V3.2 15,33 % (SD = 0,36), GPT-5.1 14,60 % (SD = 0,35) und Qwen3-Max 13,87 % (SD = 0,34). Zwischen den einzelnen Themenbereichen zeigten sich deutliche Unterschiede. So erreichte Kimi K2 bei Fragen zur endoskopischen Bildgebung eine Genauigkeit von 37,04 %, während Qwen3-Max lediglich 7,41 % erzielte.
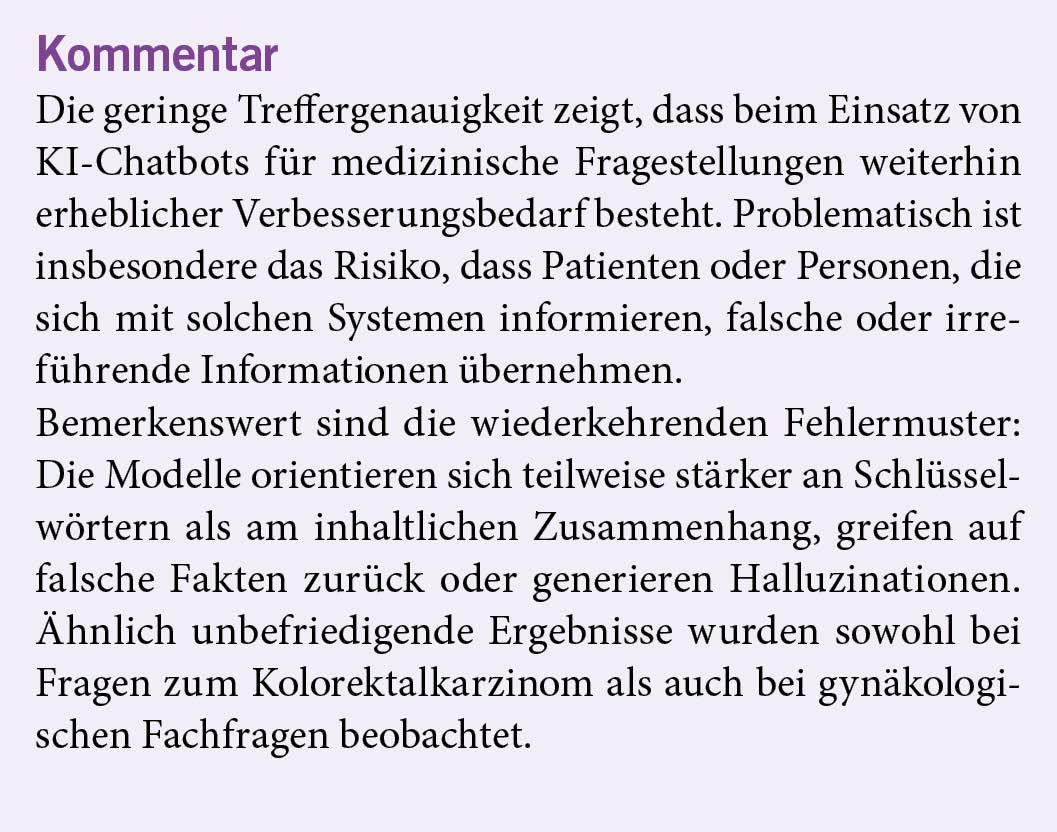
Die qualitative Analyse identifizierte vier typische Fehlermuster: Verzerrungen durch semantische Assoziationen, Fehler in der hierarchischen Logik, fehlerhaften Faktenabruf und Halluzinationen. Ein Zusammenhang zwischen dem Schwierigkeitsgrad der Aufgaben und der Genauigkeit konnte nicht festgestellt werden.
Unter den gewählten Testbedingungen zeigten die KI-Chatbots der nächsten Generation somit eine unbefriedigende Leistung bei Fragen zum Kolorektalkarzinom. Offenbar stützen sich die Modelle teilweise stärker auf Schlüsselwortassoziationen als auf ein konsistentes medizinisches Verständnis. Dies kann zu klinisch relevanten Fehlentscheidungen führen und unterstreicht die Notwendigkeit geeigneter Prompt-Strategien, fachärztlicher Kontrolle und fachspezifischer Optimierung, bevor solche Systeme unbeaufsichtigt eingesetzt werden.
Quelle: Chen H. et al. Performance of next-generation AI chatbots in colorectal cancer knowledge assessment: a comparative pilot study of ChatGPT-5.1, Gemini-3 Pro Preview, DeepSeek-V3.2, Kimi K2 Thinking, Qwen3-Max and Claude Opus 4.5. Updates Surg. 2026. https://doi.org/10.1007/s13304-026-02766-9
KI-Chatbots im Wissenstest: Gynäkologie
Mit der raschen Weiterentwicklung künstlicher Intelligenz gewinnt die Frage an Bedeutung, wie zuverlässig KI-Modelle in spezialisierten medizinischen Fachgebieten eingesetzt werden können. Während grosse Sprachmodelle in der Allgemeinmedizin teilweise vielversprechende Ergebnisse erzielt haben, ist ihre Zuverlässigkeit bei komplexen gynäkologischen Fragestellungen bislang nur unzureichend untersucht. Ziel dieser Pilotstudie war es daher, Wissen, Sicherheit und Grenzen der Schlussfolgerungsfähigkeit fortschrittlicher KI-Chatbots in der Gynäkologie vergleichend zu bewerten.
Methoden
Insgesamt wurden 70 textbasierte Multiple-Choice-Fragen aus sieben zentralen gynäkologischen Themenbereichen aus den «USMLE Step 1 Sample Test Questions» adaptiert. Getestet wurden ChatGPT-5, Gemini-3, DeepSeek-V3.2 und Claude-4.5-Opus. Um eine Situation mit rascher Informationsbeschaffung zu simulieren, wurden die Modelle unter Zero-Shot-Bedingungen getestet und angewiesen, keine einzelnen Schlussfolgerungsschritte darzustellen. Die Autoren führten sowohl quantitative statistische Analysen (Kruskal-Wallis, Cochran-Q) als auch qualitative Fehleranalysen durch.
Ergebnisse
Die Gesamtgenauigkeit fiel auch bei diesen fortgeschrittenen Modellen niedrig aus: Gemini-3 erreichte 32,86 %, DeepSeek-V3.2 30,00 %, ChatGPT-5 25,71 % und Claude-4.5-Opus 21,43 %. Zwischen den einzelnen Themenbereichen bestanden deutliche Leistungsunterschiede. Auffällig war beispielsweise, dass ChatGPT-5 im Bereich «Unfruchtbarkeit» keine einzige Frage korrekt beantwortete, während DeepSeek-V3.2 bei «häufigen gutartigen Erkrankungen» eine Genauigkeit von 70,00 % erreichte.
Die qualitative Analyse zeigte drei wesentliche Fehlermuster: semantische Assoziationsverzerrungen, Schwierigkeiten bei der räumlichen anatomischen Zuordnung sowie eine fehlerhafte Interpretation genetischer Zusammenhänge. Zwischen dem Schwierigkeitsgrad der Aufgaben und der Genauigkeit bestand keine signifikante Korrelation (p > 0,05).
Schlussfolgerung
Unter den gewählten Testbedingungen zeigten auch KI-Chatbots der nächsten Generation bei gynäkologischen Fachfragen eine unbefriedigende Leistung. Die Fehleranalyse deutet darauf hin, dass sich die Modelle teilweise stärker auf probabilistische Schlüsselwortassoziationen als auf ein konsistentes medizinisches Verständnis stützen. Dies kann zu potenziell gefährlichen klinischen Fehleinschätzungen führen. Für einen unbeaufsichtigten Einsatz in der gynäkologischen Aus- und Weiterbildung erscheint die derzeitige Zuverlässigkeit daher nicht ausreichend. Die Ergebnisse unterstreichen die Bedeutung geeigneter Prompt-Strategien und einer fachlichen Kontrolle durch medizinische Experten.
Quelle: Huan O, Wang Z. Performance of next-generation AI chatbots in gynecological knowledge assessment: a comparative pilot study of ChatGPT-5, Gemini-3, DeepSeek-V3.2, and Claude-4.5-Opus. Arch Gynecol Obstet. 2026;313(1):116. DOI 10.1007/s00404-026-08358-7.
SwissBreastCare
Bethanienspital
Toblerstrasse 51
8044 Zürich